---
title: "È finita sul giornale"
subtitle: "Il New York Times accusa OpenAI, ma la vicenda non riguarda solo loro due"
author: "Lorenzo Ancona"
date: 2024-01-09
language: en
words: 1763
canonical: https://artifactstech.substack.com/p/e-finita-sul-giornale
license: CC BY 4.0
cite_as: "È finita sul giornale by Lorenzo Ancona, Artifacts, 2024-01-09. https://artifactstech.substack.com/p/e-finita-sul-giornale (CC BY 4.0)"
---
# È finita sul giornale
Sei un giornalista. Nel 2014 hai scritto un classico articolo di previsioni per il 2024 in Italia.
Tra Natale e Capodanno del ‘23, nell’ozio, ti ricordi di quell’articolo. E chiedi a ChatGPT di scrivere un pezzo simile. E - sorpresa - ripete proprio quello che hai scritto tu qualche anno fa, magari con le stesse parole.
Reazione: “Ah, l’Intelligenza Artificiale mi copia!”.
E, sì, puoi esserne contento, perché magari non te lo aspetti, ma soprattutto, poi, preoccupato e sconvolto, perché non ne sapevi nulla, non hai mai dato il permesso né hai visto un centesimo.
Ecco, su scala decisamente più grande, questo è il motivo per cui, tra Natale e Capodanno, il New York Times, forse il giornale più importante del mondo, ha fatto causa ad OpenAI per violazione del copyright nella creazione di GPT, il modello dietro ChatGPT.
 Un giornale super arrotolato. Creato con DALL-E
Detta bene, milioni di articoli sarebbero stati utilizzati per il training del modello di linguaggio, senza alcun tipo di consenso da parte del NYT né accordo economico tra le due parti (!)
E, di conseguenza, se ChatGPT è così potente, sarebbe anche perché “contiene” - e questo lo approfondiamo dopo - il lavoro di migliaia di giornalisti del NYT. Il tutto senza un euro (o meglio, un dollaro) corrisposto da OpenAI al giornale.
Com’è potuto succedere? Il training di GPT è stato fatto anche su Common Crawl, un enorme dataset, che ambisce a essere una “copia di internet”, di cui il NYT è la terza fonte più rappresentata. Ingegnere che mi leggi, chiedo venia.
E al NYT non l’hanno presa bene, affatto. Alla corte di Manhattan, infatti, chiedono in primis che OpenAI li risarcisca, senza specificare la somma, ma ci si immagina tanti zeri con un numero prima. E, soprattutto, di DISTRUGGERE sia GPT che tutti i modelli che contengono i lavori del NYT.
L’ho spiegata in un tweet. Per i più curiosi, qui trovi il Plaintiff completo sottolineato ed evidenziato da me. A me piace leggere le cose sottolineate da altri, spero anche a te.
------------------------------------------------------------------------
Più che raccontare il caso, cosa che molti hanno già fatto bene, mi interessa però vederne alcuni aspetti davvero interessanti. Perché questo caso non è solo NYT vs OpenAI, ma può davvero scrivere, o riscrivere, molto del futuro dell’AI e del giornalismo.
Al NYT lo sanno bene e lo dicono meglio:
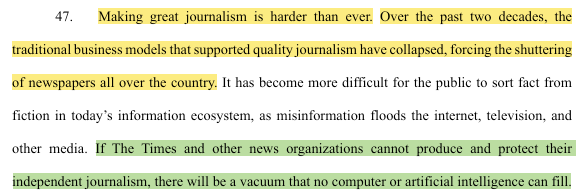 Davvero l’ho letto e sottolineato tutto, eh!
Insomma, il giornalismo non è nel suo miglior momento, e non è certo auspicabile che il lavoro che produce venga rubato - nella loro prospettiva - per fare il training delle IA. Per ribadire la gravità della situazione, dopo scrivono “Less journalism will be produced, and the cost to society will be enormous”.
Non corriamo. Il framing che fa il NYT di questa vicenda è incredibile: sembrano andare oltre il torto subito, e assumere piuttosto il ruolo di difensori del futuro di tutto il giornalismo. Noi buoni e loro, OpenAI, cattivi, che mettono a rischio la società. Vabbè, insomma, chi meglio del NYT a comunicare.
A onor del vero, però, non tutti i giornali la vedono così. Axel Springer, proprietaria di Politico e Business Insider, a inizio dicembre ha fatto un accordo con OpenAI perché ChatGPT possa prendere le informazioni dai loro siti. E anche Associated Press ha un accordo perché gli articoli siano utilizzati per il training dei modelli di OpenAI. Chiaramente, non pochi dollari dietro.
Al contrario, il NYT non ha trovato accordi, nonostante delle negoziazioni. Nel frattempo, negli scorsi mesi ha bloccato sul suo sito il web crawler di OpenAI, ossia il tool che serve a prendere i contenuti e poi usarli per il training.
------------------------------------------------------------------------
Questa storia, però, non è affatto semplice. La narrazione buoni vs cattivi regge fino a un certo punto. La realtà è più sfumata e ricca di insidie.
Allora, oggi Artifacts vedrà perché ad OpenAI non si sono fatti problemi a prendere gli articoli del NYT, pensando che fosse fair, come ChatGPT può diventare un competitor di un giornale, ma anche quali sono gli scenari plausibili di tutta questa storia.
> ### La Storia
La domanda, legittima, è: “Dopo aver utilizzato milioni di articoli, ad OpenAI si sorprendono di essere accusati?”. In una certa misura, sì.
Come sostengono nella nota uscita proprio ieri sera, e che mi ha costretto a rimettere mano a questa Artifacts :), OpenAI pensa che “fare il training dei modelli AI utilizzando dataset pubblici è fair use”. Concetto già visto mesi fa qui:
 #### Le IA potrebbero star leggendo troppi libri
Lorenzo Ancona·3 October 2023Read full story
Per i non iscritti al tempo, il fair use è il principio per cui delle opere coperte da copyright possono essere utilizzate per alcuni usi specifici, ad esempio la ricerca accademica. Dipende da 4 principi: lo scopo dell’utilizzo, l’impatto sul mercato, quanto contenuto originale si prende, e la natura dell’opera originale. E si considera soprattutto il carattere “transformative” di quello che si produce, ossia se è sufficientemente diverso dall’opera a cui ci si è ispirati.
Ecco, stabilire se l’utilizzo di OpenAI degli articoli del NYT sia fair use, e quindi se quello che scrive ChatGPT è transformative, è più complesso di quello che si pensi.
Chiedendo sempre scusa all’ingegnere di cui sopra, il modello GPT non conserva nè ricorda i testi - e quindi gli articoli del NYT - ma converte le parole in dei pezzettini (i tokens), che utilizza poi per calcolare la probabilità statistica che ad una certa parola ne segua un altra. Insomma, gli articoli in realtà vengono distrutti e non sono conservati da nessuna parte. Per chi si fosse incuriosito, qua è spiegato bene bene.
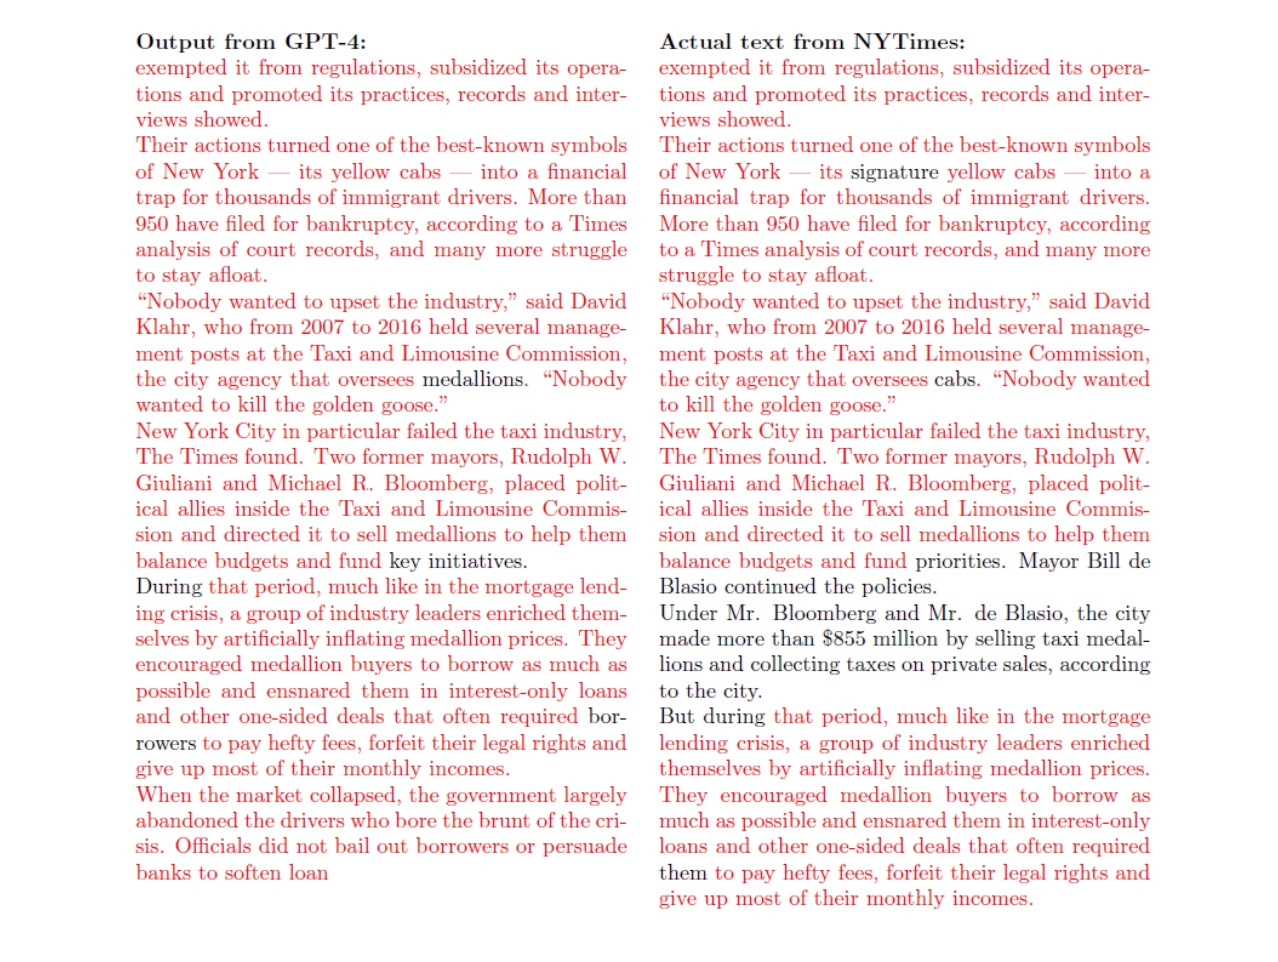
Eppure, nella pratica, il NYT ha fatto un documento con 1000 casi come questo:
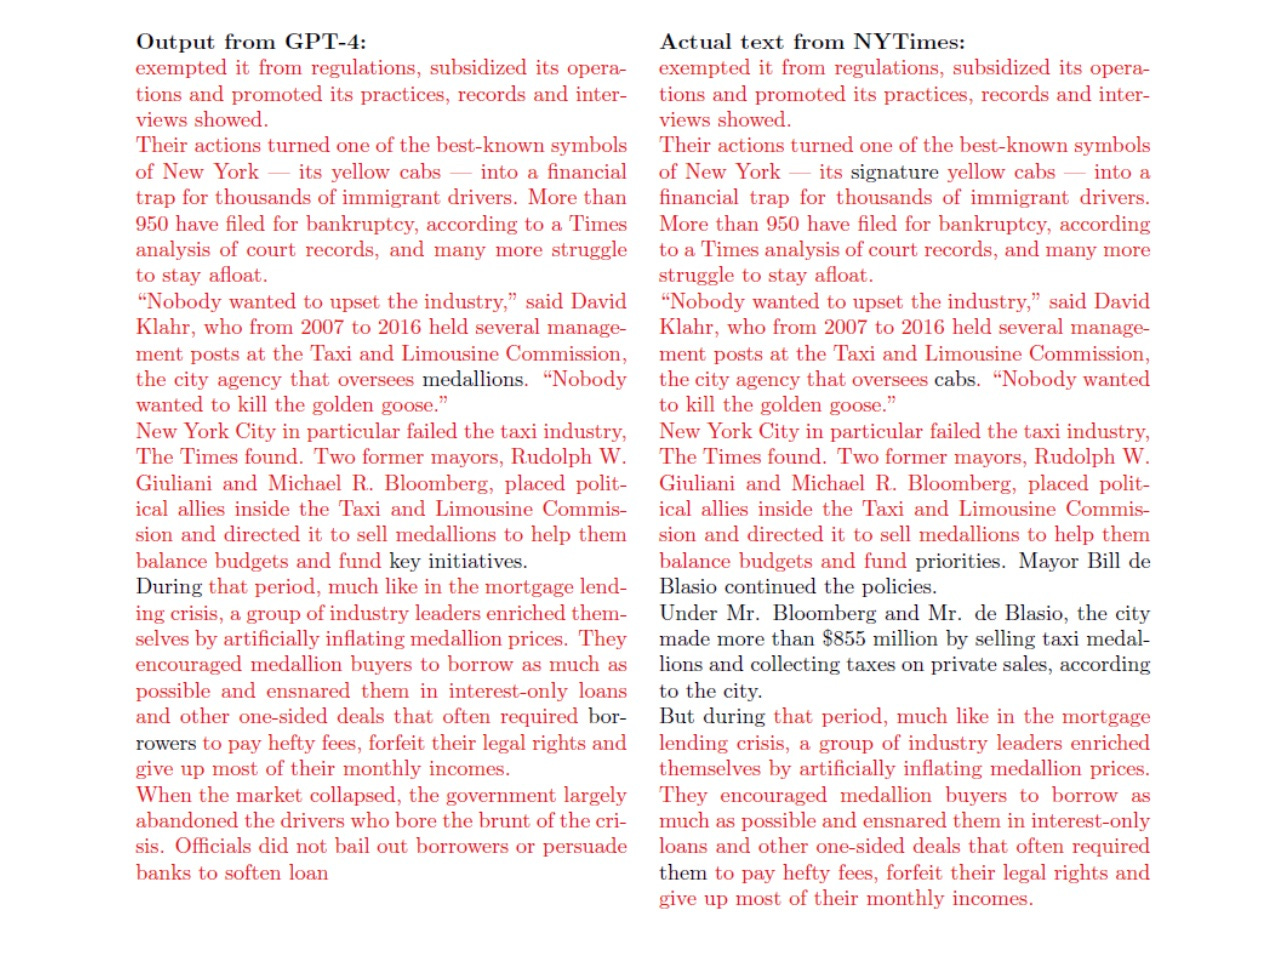 1000 indizi fanno una prova?
L’obiettivo è dimostrare che, se richiesto dall’utente, ChatGPT può in realtà fare una copia degli articoli del NYT. Qui, chiaramente, cadrebbe il carattere transformative. OpenAI, però, ha prontamente risolto casi simili di “memorizzazione” e ha anche insinuato che il NYT abbia artefatto il documento con i 1000 casi.
------------------------------------------------------------------------
Comunque, al di là delle elucubrazioni legali, la grande preoccupazione del NYT è una: che un ChatGPT possa diventare un loro competitor. E che, peggio ancora, lo diventi sfruttando, senza pagare, il lavoro fatto dal NYT. Insomma, la storia del danno e della beffa.
Lo potrebbe diventare per la potenza e capacità di scrittura, cosa che però è difficilmente contestabile. Ma soprattutto perché gli utenti - e personalmente mi capità già - potrebbero cominciare ad utilizzare ChatGPT (nella versione Plus) o altri chatbot come usiamo Google o altri motori di ricerca. Con una differenza decisiva: che ci accontentiamo del testo prodotto e smettiamo di cliccare sui link ai siti, che è come i siti fanno soldi.
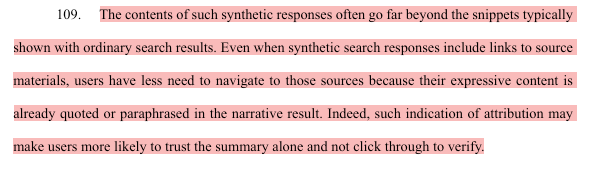 Questo concetto il NYT lo mette così
Tra l’altro, sempre rispetto all’utilizzo di ChatGPT tipo Google, c’è un problema non piccolo di disinformazione. Con la leggerezza che ha contraddistinto il NYT, nell’accusa scrivono “In AI parlance, this is called a “hallucination.” In plain English, it’s misinformation.” Il riferimento è a casi in cui il chatbot inventa notizie, attribuendole al NYT, portando un inevitabile danno di immagine.
------------------------------------------------------------------------
Giocando alla sfera di cristallo, come può andare a finire? Ci sono, al momento, 3 scenari plausibili:
1. NYT e OpenAI trovano un accordo, tipo quello che esiste con altre testate, e il giornale riceve denaro in cambio degli articoli. È lo scenario che si auspica OpenAI, e andrebbe a creare un importante precedente nel mondo dei media;
2. La Corte dà ragione al NYT: OpenAI deve risarcire il giornale e distruggere i suoi modelli che contengono gli articoli. Inutile da dire, sarebbe una rivoluzione nel mondo dell’AI;
3. La Corte dà ragione a OpenAI: si tratta di fair use, non c’è violazione di copyright. E al NYT non la prenderebbero affatto bene.
La mia opinione è che, in qualche modo, si cercherà di far avvenire lo scenario 1, perché il 2 e il 3 avrebbero dei costi troppo alti per una delle due parti. E sia NYT che OpenAI sono too big to fail.
Il vero problema, però, sarà il come. Ossia, come potrebbe essere stabilito un accordo che tenga conto di tutti gli articoli che sono già presenti nei GPT. Come detto prima, non c’è un vero e proprio database, ma gli articoli sono frammentati in pezzetti di testo. E, soprattutto, è verosimile che una eventuale richiesta del NYT sarebbe particolarmente alta.
Da ultimo, se è vero che un accordo creerebbe un precedente nel mondo dei media, questo tipo di risoluzione non sarebbe valida per tutti. O meglio, come spiega anche bene Valigia Blu, OpenAI e aziende simili avrebbero sì interesse a stringere accordi con media grandi, tipo NYT, ma è difficile pensare che possano farlo, o abbia anche solo senso farlo, con testate più piccole. E questo, inevitabilmente, sarebbe un’ennesima bordata per i non giganti.
Insomma, è una questione enorme, complessa da districare, e con potenziali implicazioni storiche. C’è in ballo il futuro dei giornali, dell’AI, ma anche del modo in cui ci informiamo.
Inizia leggero il 2024.
------------------------------------------------------------------------
E tu cosa ne pensi? Come pensi andrà a finire? Sei team NYT o OpenAI?
Leave a comment
> ### Rassegna (Stampa)
L’UE se l’è presa pure con Pornhub e simili. “Eh non si può più fare proprio niente qua!”
Sempre per ragioni di copyright, ora potete fare Topolino comunista. Anzi, lo hanno già fatto.
Microsoft scommette così tanto sull’AI che metterà un tasto apposta sui computer. A Deloitte pure provano a semplificarsi la vita.
Al NYT hanno provato a fare un mese col telefono al conchiglia.
Su temi tipo quelli di Artifacts, ho cominciato a fare dei video per NOS, un progetto tanto bello quanto ambizioso. L’immagine è cliccabile, così potete seguire la pagina, spero :)
 > ### Lo Scaffale
 Vero che il giornalismo non è nel suo momento migliore, ma vero anche che qualche anno fa ne hanno fatta di ogni. Traffic di Ben Smith, spiega bene come l’ossessione della viralità ha compromesso la qualità dell’informazione, creando un modello non proprio virtuoso.
> ### Nerding
 Non hai voglia di leggere Artifacts? Beh, con Speechify puoi ascoltarla. App super utile che permette di farsi raccontare, da voci molto poco robotiche, articoli, newsletter e simili. Se siete stanchi, ottima!
 1000 indizi fanno una prova?
L’obiettivo è dimostrare che, se richiesto dall’utente, ChatGPT può in realtà fare una copia degli articoli del NYT. Qui, chiaramente, cadrebbe il carattere transformative. OpenAI, però, ha prontamente risolto casi simili di “memorizzazione” e ha anche insinuato che il NYT abbia artefatto il documento con i 1000 casi.
------------------------------------------------------------------------
Comunque, al di là delle elucubrazioni legali, la grande preoccupazione del NYT è una: che un ChatGPT possa diventare un loro competitor. E che, peggio ancora, lo diventi sfruttando, senza pagare, il lavoro fatto dal NYT. Insomma, la storia del danno e della beffa.
Lo potrebbe diventare per la potenza e capacità di scrittura, cosa che però è difficilmente contestabile. Ma soprattutto perché gli utenti - e personalmente mi capità già - potrebbero cominciare ad utilizzare ChatGPT (nella versione Plus) o altri chatbot come usiamo Google o altri motori di ricerca. Con una differenza decisiva: che ci accontentiamo del testo prodotto e smettiamo di cliccare sui link ai siti, che è come i siti fanno soldi.
 Vero che il giornalismo non è nel suo momento migliore, ma vero anche che qualche anno fa ne hanno fatta di ogni. Traffic di Ben Smith, spiega bene come l’ossessione della viralità ha compromesso la qualità dell’informazione, creando un modello non proprio virtuoso.
> ### Nerding
 Non hai voglia di leggere Artifacts? Beh, con Speechify puoi ascoltarla. App super utile che permette di farsi raccontare, da voci molto poco robotiche, articoli, newsletter e simili. Se siete stanchi, ottima!